

Is jouw organisatie klaar voor AI? Zo meet je AI-readiness
Iedereen meet AI-adoptie. Bijna niemand meet readiness.
Elke directie stelt inmiddels dezelfde vraag. Doen we iets met AI? De meeste managementteams antwoorden moeiteloos. Ja, meerdere dingen. Dan stelt iemand de moeilijkere versie. Hoe klaar zijn we nu echt? Dan wordt het stil, want niemand heeft een cijfer. Die kloof tussen activiteit en AI-readiness is waar dit artikel over gaat. Je kunt die betrouwbaar meten, en de eerste ronde kost ongeveer twintig minuten.
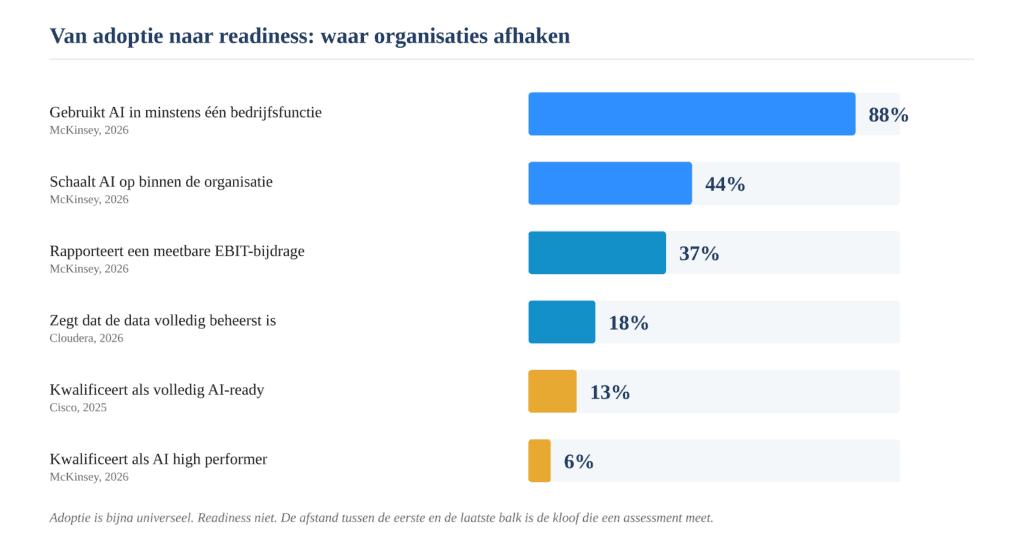
Het onderzoek is helder over die kloof. Uit het State of AI-onderzoek van McKinsey (augustus 2026) blijkt dat 88 procent van de organisaties AI gebruikt in minstens één bedrijfsfunctie, maar dat slechts 6 procent high performer is. De AI Readiness Index van Cisco komt uit op ongeveer 13 procent volledig gereed, al drie jaar vrijwel onveranderd.
Adoptie steeg dus, readiness stond stil. De organisaties die de kloof wél dichtten, kochten niet meer tools. Ze stopten met gissen en begonnen met scoren.
Wat wij zien bij MKB+ organisaties
De meeste organisaties die bij ons aankloppen voor een AI-scan verwachten dat het oordeel over technologie gaat. Dat is het bijna nooit.
Het patroon bij MKB+ organisaties is consistent, en positiever dan mensen verwachten. Heb je de afgelopen jaren geïnvesteerd in Power BI, dan staat je datafundament meestal verder dan je denkt. Wat achterblijft is governance, training en meten: toegang die per rapport is ingericht door wie dat rapport bouwde, licenties die zijn uitgedeeld zonder training, en pilots waarvan niemand vooraf afsprak hoe je ze zou beoordelen.
Dat is een goede positie, want juist die drie zijn het goedkoopst om te verhogen. Ze vragen besluiten en een beetje structuur, geen nieuw platform.
Herken je dit?
Elke afdeling heeft zijn eigen AI-experiment, en niets daarvan deelt data, definities of governance.
- Je rapportages en je AI-tools spreken elkaar tegen, waardoor een assistent je sneller en met meer overtuiging het verkeerde antwoord geeft.
- Een pilot werkte, iedereen was tevreden, en een jaar later staat hij nog steeds niet in productie.
- De EU AI Act is niet langer iets wat je jurist noemt, maar iets met datums eraan. Niemand kan opsommen welke tool welke data raakt.
Herken je twee of meer van deze punten, dan is het probleem niet je AI. Niemand heeft de grond eronder gemeten.
Wat het kost om het meten over te slaan
Eén voorspelling van Gartner verdient een plek boven je bureau. Tot en met 2026 stoppen organisaties met 60 procent van de AI-projecten die geen AI-gereed datafundament hebben.
De ongemakkelijkere bevinding gaat over vertrouwen. Cloudera ondervroeg begin 2026 1.270 IT-leiders. Zesennegentig procent zei dat AI is geïntegreerd in kernprocessen. Vierentachtig procent zei de juistheid van hun data te vertrouwen. Achttien procent zei dat hun data volledig beheerst is.
Vertrouwen loopt dus ongeveer vier keer voor op governance, en geen enkele extra technologie dicht dat gat, want het is een meetprobleem.
De compliance-klok die al loopt
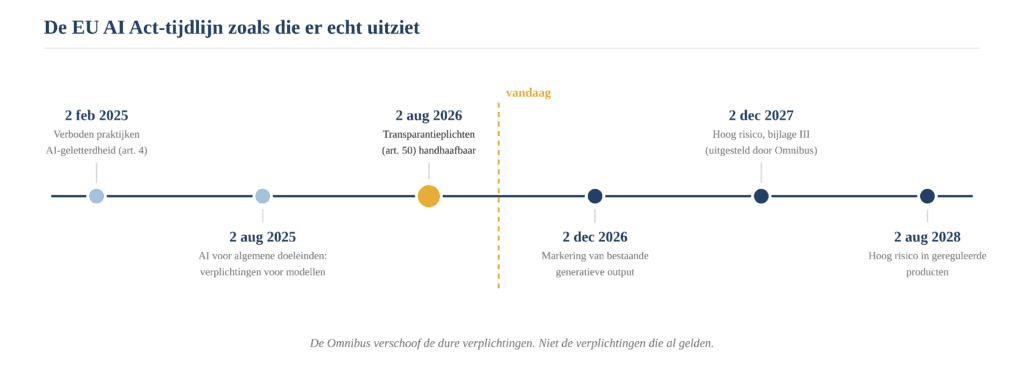
Er circuleert een hardnekkige misvatting over de EU AI Act. De AI Omnibus, Verordening (EU) 2026/1744, stelde de verplichtingen voor hoog-risicosystemen uit naar december 2027 en augustus 2028. Dat is het deel dat iedereen herhaalt.
Artikel 50 is niet uitgesteld. Sinds 2 augustus 2026 zijn de transparantieverplichtingen daaruit handhaafbaar, ongeacht risicoclassificatie. Zet je een chatbot in, dan moeten mensen te horen krijgen dat ze met een machine praten.
De verplichting die bijna iedereen heeft gemist
Artikel 4 van de EU AI Act draait om AI-geletterdheid binnen organisaties. Sinds de wijziging van juli 2026 zijn aanbieders en gebruiksverantwoordelijken van AI-systemen verplicht om maatregelen te nemen die de ontwikkeling van AI-geletterdheid bij medewerkers en andere gebruikers ondersteunen.
Daarbij moet rekening worden gehouden met hun technische kennis, ervaring, opleiding en de context waarin AI wordt gebruikt. De wet verplicht organisaties niet om voor iedere medewerker een specifiek niveau van AI-geletterdheid te garanderen.
Geef je finance-team bijvoorbeeld toegang tot Copilot zonder aandacht te besteden aan kennis, training en verantwoord gebruik, dan vergroot je niet alleen het risico op zwakke adoptie en onbetrouwbare output, maar mis je ook een belangrijk onderdeel van goed AI-beleid.
De vijf niveaus van AI-maturity
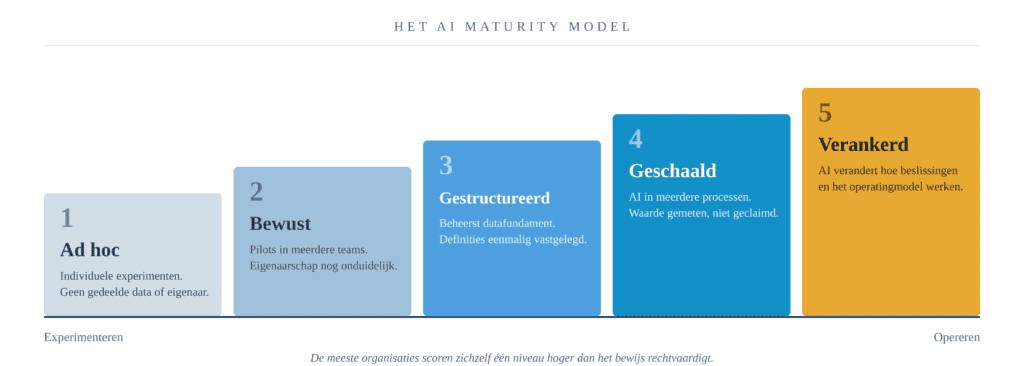
Een AI maturity model is een schaal. Het verandert een vage vraag, zijn we er klaar voor, in een positiebepaling: we staan hier, en dit is de volgende stap. Het model hieronder is van ons. We bouwden het voor organisaties die al met Power BI werken, want daar beginnen de meeste van onze klanten.
- Ad hoc. Individuen experimenteren. Prompts leven in browsertabs, resultaten in screenshots, en niets wordt gedeeld. Veel enthousiasme, geen eigenaar. Het gevaar is dat je hier twee jaar blijft terwijl je denkt dat je op niveau drie staat.
- Bewust. Meerdere teams draaien pilots en de directie is geïnteresseerd. Data reist nog steeds via exports, en eigenaarschap wordt nooit belegd. Het drukste niveau, en het meest misleidende, omdat activiteit zo sterk op voortgang lijkt.
- Gestructureerd. Er is een beheerst datafundament. Omzet, marge en actieve klant zijn één keer afgesproken en overal toegepast. Dit is het eerste niveau waarop je een AI-antwoord kunt vertrouwen, omdat je kunt vertrouwen waar dat antwoord vandaan komt.
- Geschaald. AI zit in bedrijfsprocessen met benoemde eigenaren, en waarde wordt gemeten in plaats van geclaimd. McKinsey vond dat 73 procent van de high performers processen opnieuw had ingericht, tegenover 25 procent van alle anderen.
- Verankerd. AI verandert hoe beslissingen tot stand komen. Weinig middelgrote organisaties staan hier, en dat is geen tekortkoming. Niveau vier is een prima plek om een winstgevend bedrijf vanuit te runnen.
Wat meten beter maakt dan gissen
- Het maakt de beperking zichtbaar. Meningen middelen elkaar uit tot alles oranje lijkt. Een score benoemt de ene dimensie die je volgende use case tegenhoudt, en dat is zelden degene waarover werd gediscussieerd.
- Het maakt van readiness een businesscase. We zijn er niet klaar voor is geen businesscase. Governance scoort twee, dit kost niveau drie en dit levert het op, is dat wel.
- Het geeft je een startpunt om te verbeteren. Meet je jaarlijks, dan wordt readiness een trendlijn, en dat is de enige eerlijke manier om te beantwoorden of de AI-uitgaven van vorig jaar iets hebben opgeleverd.
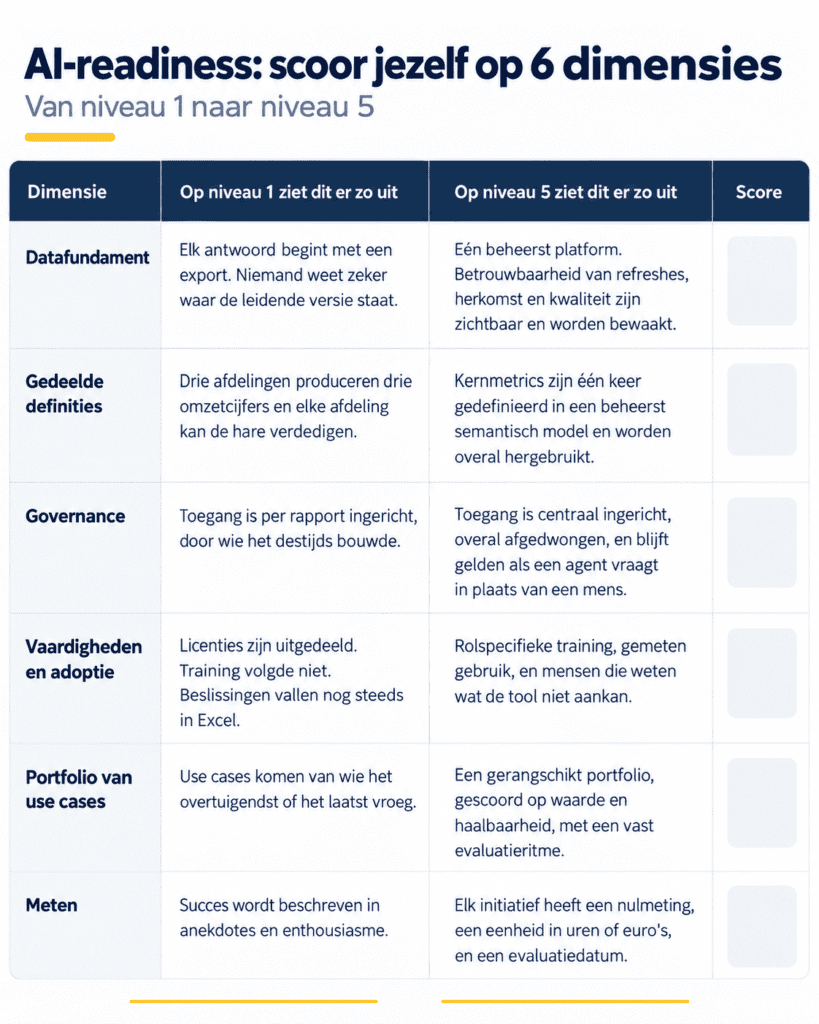
Scoor jezelf: de zes dimensies
Neem twintig minuten met je BI-lead en iemand van finance. Bepaal per dimensie welke omschrijving het dichtst bij je werkelijkheid ligt, en schrijf er een cijfer van één tot vijf bij.
Waarom je readiness je laagste score is, niet je gemiddelde
Een gemiddelde vleit, en precies daarom grijpen mensen ernaar. Scoor vijf op datafundament, vijf op vaardigheden en één op governance, en je readiness is geen 3,7. Je hebt een governanceprobleem dat je eerste serieuze use case tegenhoudt, en alles wat je elders wél goed doet is waarde die je nog niet kunt verzilveren. Dit is de fout die we het vaakst zien bij zelfscans. Neem het minimum. Repareer het minimum. Scoor daarna opnieuw.
Een zelfscan vertelt je waar je denkt te staan, en dat is een nuttig startpunt. Onze gratis AI Readiness Check doet dat in een paar minuten. Een AI-scan toetst die antwoorden aan bewijs uit je eigen platform en maakt er een doorgerekend plan van.
Wat dit betekent als je al met Power BI werkt
Dit is het deel dat mensen positief verrast. Je semantische model, de laag in Power BI waar je cijfers worden gedefinieerd, is het waardevolste bezit in een AI readiness assessment. Zijn omzet, marge en actieve klant één keer gedefinieerd en overal hergebruikt, dan heb je het dure deel al gedaan.
Drie checks bepalen of AI-functies echt voor je gaan werken, en niet alleen beschikbaar zijn.
- Heb je de juiste Fabric-capaciteit en is Copilot goed ingericht? Copilot is standaard ingeschakeld voor tenants met een betaalde Fabric-capaciteit vanaf F2. Beheerders kunnen vervolgens bepalen welke gebruikers en workspaces toegang krijgen en hoe het gebruik binnen de organisatie wordt ingericht.
- Is je model begrijpelijk voor een machine? Copilot leest je tabel- en kolomnamen als betekenis en kan niet vanzelf bepalen welke van je drie omzetmaatstaven de juiste is. Duidelijke namen en één gezaghebbende maatstaf per begrip doen het meeste werk.
- Blijft toegang gelden als een agent vraagt in plaats van een mens? Iemand die een cijfer ziet dat hij niet hoort te zien, merkt dat meestal. Een agent vat het samen en geeft het door.
Dat is de versie op businessniveau, en voor een readiness-score is dat genoeg. De platformdetails staan in ons artikel over Microsoft Fabric en AI, en de bredere vraag over controle in AI-governance uitgelegd.
Twee voorbeelden, en één waarschuwing
- Universiteit Antwerpen. Data versnipperd over verouderde Oracle- en SAP-systemen, financiële rapportage per kwartaal. Na de herbouw op Microsoft Fabric daalde de dataverwerkingstijd met 65 procent en ging de rapportage naar dagelijks. Het detail dat ertoe doet is wat het project niet was. Er is geen AI-model uitgerold. Dit is niveau twee naar niveau drie, en dat is wat alles daarna mogelijk maakt.
- CVC DIF. Onze klant, een wereldwijde infrastructuurinvesteerder met 19 miljard euro aan beheerd vermogen, had berekeningen nodig die de bestaande systemen niet konden modelleren. Wij bouwden de datapijplijnen, de datamodellen en de dashboards, en vervingen Excel-invoer door gestructureerde bronnen. Finance rapporteert nu vrijwel realtime. Verhoogde dimensies: datafundament en gedeelde definities. De volledige casestudy van CVC DIF staat op onze site.
- Air Canada, als waarschuwing. In februari 2024 achtte een tribunaal de luchtvaartmaatschappij aansprakelijk nadat de chatbot op haar website een klant onjuiste informatie gaf over rouwtarieven. Air Canada voerde aan dat de chatbot een aparte rechtspersoon was, verantwoordelijk voor zijn eigen uitspraken. Dat argument werd volledig verworpen. Het principe blijft staan: een organisatie is eigenaar van wat haar AI zegt.
Geen van de eerste twee begon met het kopen van een AI-tool. Beide vonden hun laagst scorende dimensie en verhoogden die. Daar is een AI readiness assessment voor, en daarom werkt de AI-roadmap die eruit komt aanzienlijk beter.

Vijf praktische tips voordat je jezelf scoort
- Scoor het fundament vóór de ambitie. Begin bij data en definities, niet bij de lijst met use cases. Een briljante use case op een onbeheerst fundament is precies de 60 procent die Gartner beschrijft.
- Spreek definities één keer af, in het semantische model. Niet in een begrippenlijst die niemand opent. Het semantische model dat je al onderhoudt is waar een AI-agent uit redeneert, dus daar hoort gedeelde betekenis te staan.
- Scoor op bewijs, niet op mening. In onze scans beslechten we een discussie over datakwaliteit het snelst door de refreshgeschiedenis te openen en te kijken. Kun je een score niet onderbouwen, noteer hem dan als onbekend in plaats van optimistisch.
- Behandel governance als ontwerpkeuze, niet als toetsmoment. Toegangsregels die je één keer vastlegt en overal afdwingt, kosten veel minder dan ze achteraf inbouwen nadat een agent de verkeerde vraag voor de verkeerde persoon heeft beantwoord.
- Bepaal wat je gaat meten, en leg het vast in de AI-roadmap. Spreek de nulmeting af, de eenheid, uren of euro’s, en de evaluatiedatum. Een copilot aanzetten is geen resultaat. Een beslissing die aantoonbaar beter werd wel.
Conclusie: je kunt AI-readiness pas sturen als je het kunt meten
De kloof in deze markt loopt niet langer tussen organisaties die AI gebruiken en organisaties die dat niet doen. Hij loopt tussen organisaties die kunnen zeggen waar ze staan en organisaties die nog een mening geven.
De 13 procent van Cisco is in drie jaar niet bewogen terwijl de technologie enorm verbeterde, en dat vertelt je waar de echte beperking zit. Niet in het model. In de grond eronder, en die grond kun je zelf meten.
Jouw volgende stap
We houden het bewust simpel, want de meest voorkomende reden dat een readiness-gesprek stilvalt, is dat de volgende stap te groot is. Er is één route, en die begint met iets gratis.
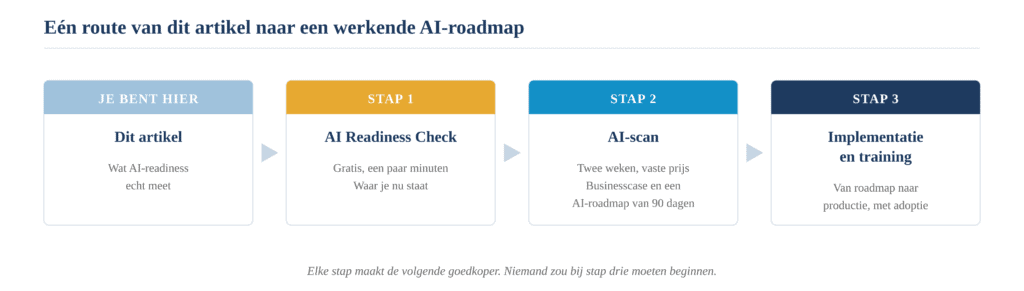
- Begin met de gratis AI Readiness Check. Die scoort je datagereedheid en je organisatiegereedheid in een paar minuten, en geeft je iets concreets om mee te nemen naar het volgende MT-overleg. Doe de check.
- Daarna de AI-scan. Twee weken, vaste scope, een vaste prijs van 2.500 euro. We brengen 10 tot 15 processen in kaart waar AI realistisch kan helpen, brengen die terug naar een top drie, bouwen een businesscase voor de sterkste kandidaat in uren en euro’s, en leveren een AI-roadmap voor 90 dagen. Meer over de AI-scan.
- Daarna implementatie en training. Een roadmap is waard wat ervan gebouwd en gebruikt wordt. Daar komen implementatie en rolspecifieke training in beeld, wat meteen de verplichting uit artikel 4 afdekt die jouw organisatie al heeft.
Amandeep, BI developer @ Data Kingdom
Veelgestelde vragen
over Microsoft Fabric en AI
Wat is Microsoft Fabric?
Is Microsoft Fabric een AI-platform?
Wat is Fabric IQ?
Wat zijn Fabric Data Agents?
Waar beginnen we als we al Power BI gebruiken?
Helpt Microsoft Fabric bij EU AI Act-compliance?

WORD OOK
KONING(IN)
VAN UW EIGEN DATA!
Maak beslissingen op basis van onderbouwde feiten in plaats van onderbuikgevoel. Krijg controle over uw eigen data!