


Power BI datamodellering: best practices voor performance en schaalbaarheid
In Power BI kan een datamodel snel onoverzichtelijk worden. Het begint bijvoorbeeld met één brede Excel-achtige tabel die bij een paar duizend rijen prima lijkt te werken. Maar zodra de datahoeveelheid toeneemt, stapelen de problemen zich op.
Een ongestructureerd model leidt tot trage rapporten, complexe relaties en moeilijk onderhoud. Binnen een solide data-architectuur (met bijvoorbeeld een data warehouse en ETL-processen) is een efficiënt datamodel essentieel voor snelle analyses en betrouwbare dashboards.
Lees alles meer in onze Power BI Gids.

Waarom een efficiënt Power BI-datamodel het verschil maakt
Efficiëntie in je datamodel is cruciaal voor de performance van rapporten en het gebruiksgemak. Een strak ontworpen model, bijvoorbeeld volgens het stermodel, versnelt queries en verbetert de compressie. Door redundantie te vermijden en alleen noodzakelijke kolommen en rijen op te nemen, kan de bestandsgrootte flink kleiner worden en draait Power BI soepeler. Dit komt omdat het engine minder hoeft door te rekenen en data compact in het geheugen kan houden.
Bovendien vergemakkelijkt een efficiënt model het datamanagement en de samenwerking. In een goed gestructureerd model staan de attributen thematisch gegroepeerd in aparte tabellen (zoals Product, Klant, Datum) in plaats van in één enorme lijst. Dat maakt het model overzichtelijker: collega’s vinden gemakkelijk de benodigde velden in aparte dimensies en hoeven niet in een alfabetische berg kolommen te zoeken. Hierdoor bespaart het team veel tijd en vermijdt men fouten.
Tips voor een efficiënt Power BI-datamodel
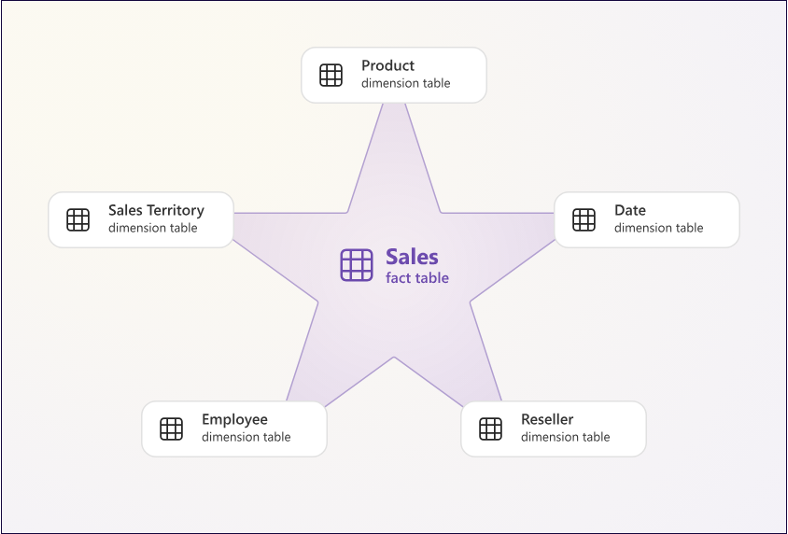
- Gebruik een stermodel: Verdeel je data in feit- en dimensietabellen (een star schema). In een stermodel bevat de feitentabel alleen sleutelkolommen en meetwaarden, terwijl de dimensietabellen beschrijvende attributen bevatten. Dit scheidt filters/groeperingen (in dimensies) van aggregaties (in feiten). Een stermodel is in de datawarehouse-wereld een bewezen aanpak voor performance en begrijpelijkheid. Zo worden queries eenvoudiger en sneller: filters gaan via kleine dimensietabellen naar de grote feittabel.
-
Kies de juiste datatypes:Gebruik altijd het meest efficiënte datatype per kolom. Zorg dat ID- of sleutelkolommen van het type integer zijn in plaats van tekst. Integers comprimeren veel beter en relaties op integer-kolommen werken sneller dan op tekst. Ook vermijd je onnodig hoge precisie of lange strings. Kort gezegd: geef elke kolom een passend, compact formaat om geheugen en rekentijd te besparen.
- Beperk het aantal relaties: Voeg alleen relaties toe die echt nodig zijn. Vermijd veel-tot-veel-relaties of bidirectionele filtering, tenzij het strikt nodig is. Te veel relaties, vooral onnodige of bidirectionele, vertragen het model omdat Power BI overal filters moet doorgeven. Houd het schema simpel: één-op-veel-relaties in een stermodel zijn het meest efficiënt. Schakel de bi-directionele optie alleen in als de analyse dit vereist.
- Gebruik measures in plaats van berekende kolommen: Leg aggregaties vast in measures (DAX-meetwaarden) en niet in extra kolommen. Measured worden bij het opvragen berekend en vergroten niet continu het model. Berekende kolommen (zeker met veel unieke waarden) comprimeren slechter en maken het model groter. Verplaats waar mogelijk berekeningen naar de laaggeneratie (Power Query of database). Zo blijft je model slanker en draait elke visualisatie vlotter.
- Laad alleen wat je nodig hebt: Importeer alleen de kolommen en rijen die je daadwerkelijk gebruikt. Filter in Power Query oude, onnodige data eruit en laad geen helper-tabel in als die alleen intern wordt gebruikt. Hoe kleiner en strakker je model, hoe sneller het laadt en refresht. Overweeg om grote tabellen vooraf te aggregeren of alleen relevante perioden mee te nemen om onnodige belastingen te vermijden.
Voorbeeld uit de praktijk
Stel, je hebt een eenvoudige verkoopdatabase met een plat tabel Orders, waarin elke rij direct de klantnaam, productnaam, categorie en verkoopbedrag bevat. In zo’n model worden klant- en productinformatie elke keer herhaald. In het verbeterde model splitsen we dit op: we maken één feitentabel Sales met kolommen als OrderID, DateKey, CustomerID, ProductID en SaleAmount, en aparte dimensietabellen DimCustomer (CustomerID, Naam), DimProduct (ProductID, Naam, Categorie) etc. Zo is Sales de sterkern (‘fact’-tabel) met alleen getalswaarden en verwijzingen, terwijl de dimensietabellen tekstuele details bevatten.
Dit verkleint het model en versnelt de queries. Zoals Salvatore Cagliari beschrijft: de centrale tabel bevat alleen de feitelijke waarden, de gescheiden dimensies houden alle voorkomende gegevens (zoals klant of product) bij. In het voorbeeld voorkom je daarmee dat een kolom als ProductName telkens herhaald wordt in Sales en behaal je een veel compacter model.
Conclusie
Een efficiënt Power BI-datamodel levert flinke tijdsbesparing en betere performance op. Goed gestructureerde modellen (zoals stermodellen) zorgen voor snellere dashboards en minder frustratie bij onderhoud. In de praktijk betekent dit: minder wachten bij verfrissing, soepelere analyses en meer vertrouwen in de data. Door slim om te gaan met datatypes, relaties en aggregaties, bouw je een datamodel dat schaalbaar blijft naarmate de organisatie groeit.
Volgende stappen
Wil je meer weten over datamodellering en praktijkvoorbeelden zien? Bekijk dan onze Power BI-dashboard voorbeelden en trainingen op de Data Kingdom website. Zo leer je in de praktijk hoe je jouw datamodel kunt optimaliseren en efficiënter maken voor jouw organisatie.

WORD OOK
KONING(IN)
VAN UW EIGEN DATA!
Maak beslissingen op basis van onderbouwde feiten in plaats van onderbuikgevoel. Krijg controle over uw eigen data!